Fremtidens Managed Services skal ikke kun måles på, hvor mange incidents der bliver håndteret. De skal i højere grad måles på, hvor mange der bliver forebygget, hvor hurtigt kritiske services bliver stabiliseret, og hvor meget kapacitet IT kan frigøre til forretningens udvikling.
Det kræver en driftsmodel, hvor AI og automatisering ikke bliver lagt oven på eksisterende processer som et ekstra lag, men er tænkt ind fra begyndelsen.
Et mønster, vi ofte ser i dialogen med danske CIO’er, er, at organisationerne har mere driftsdata end nogensinde, men stadig mangler et samlet operationelt overblik.
Monitoreringsværktøjer genererer events. Service management-platformen genererer tickets. Cloudplatformene viser forbrug. Leverandørerne rapporterer hver deres SLA’er.
Alligevel kan det være svært at svare klart på de spørgsmål, der betyder mest for ledelsen: Hvilke forretningskritiske services er reelt i risiko? Hvad oplever brugerne? Hvor opstår de tilbagevendende problemer? Hvad koster de? Og hvor vil en investering skabe størst forbedring?
Det er en af de udfordringer, næste generation af Managed Services skal løse. Opgaven er ikke blot at automatisere den eksisterende drift, men at forbinde driftsdata, forretningskontekst, handling og løbende modernisering i én sammenhængende model.
Danmark er langt fremme med AI. Nu skal værdien skaleres
I 2025 anvendte 42 % af danske virksomheder med mindst ti ansatte AI. Det var den højeste andel i EU. Samtidig viser CGI Voice of Our Clients 2026, at kun 51 % af organisationerne kvantificerer resultaterne af deres AI-initiativer.
Der er med andre ord stadig et betydeligt gap mellem adoption og dokumenteret værdi.
For CIO’en er spørgsmålet derfor ikke længere kun, om AI skal anvendes, men hvor AI skal indbygges i den operationelle model, og hvordan værdien kan dokumenteres uden at gå på kompromis med sikkerhed, transparens og menneskelig kontrol.
Det gælder især organisationer med hybride miljøer, flere leverandører og en blanding af moderne cloudservices og forretningskritiske kernesystemer. Her skaber flere værktøjer ikke nødvendigvis bedre styring. Uden en fælles servicekontekst risikerer man blot at automatisere lokale aktiviteter uden at forbedre den samlede service.
Fra isolerede towers til én samlet driftsmodel
Traditionelle Managed Services er ofte organiseret omkring separate tekniske områder. Applikationer, infrastruktur, netværk, cloud og servicedesk har egne teams, værktøjer og målepunkter.
Den model kan godt leve op til de enkelte SLA’er og samtidig give en utilfredsstillende oplevelse for forretningen. En ticket kan være lukket, selv om den underliggende årsag består. Hundreder af alarmer kan i virkeligheden være symptomer på det samme problem.
Næste generation af Managed Services kræver derfor tre skift:
For det første skal driften styres efter forretningsservices frem for tekniske komponenter. For det andet skal fokus flyttes fra reaktion til forebyggelse. Og for det tredje skal værdien i højere grad måles på robusthed, brugeroplevelse, hastighed og frigjort kapacitet, frem for alene på aktivitet og ressourceforbrug.
Det er udgangspunktet for CGI DigiOps.
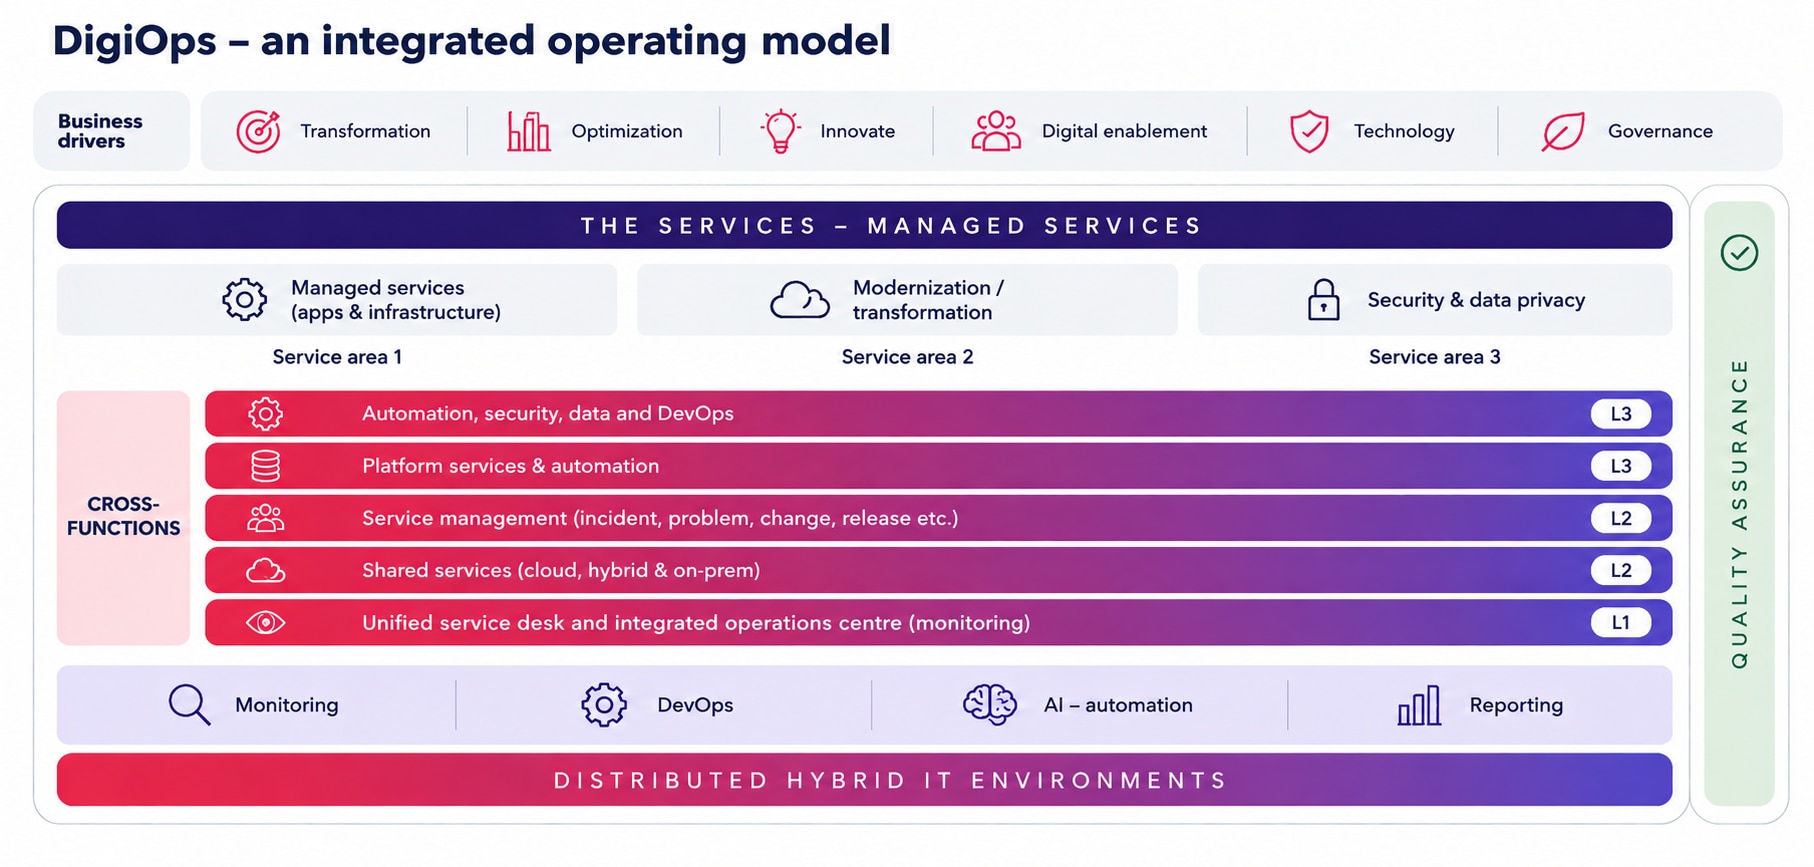
DigiOps forbinder indsigt, drift og handling
CGI DigiOps er ikke ét isoleret værktøj. Det er CGI’s leverancemodel for Managed Services, hvor AI, automation og et integreret værktøjslag er tænkt ind fra begyndelsen.
Modellen bygger på en kombination af kundens eksisterende teknologier, CGI’s egne løsninger og relevante partnere. Målet er ikke at erstatte et velfungerende setup, men at skabe sammenhæng og tilføre de kapabiliteter, der mangler for at kunne se, forstå og handle på tværs af miljøet.
DigiOps skaber sammenhæng mellem det, organisationen ser, det der sker i driften, og de handlinger der skal forbedre den.
ServiceInsight skaber et fælles beslutningsgrundlag
CGI ServiceInsight samler data på tværs af interne teams, leverandører, service management, applikationer og infrastruktur i ét fælles ledelsesoverblik.
Det gør det muligt at koble driftsperformance, brugeroplevelse, omkostninger og tekniske afhængigheder til de forretningsservices, de understøtter. Platformen understøtter mere end 100 integrationer og over 500 standard-KPI’er og kan også anvende experience level agreements, så organisationen ikke kun måler, om den tekniske SLA er overholdt, men også hvordan servicen faktisk opleves.
For CIO’en er værdien ikke endnu et dashboard. Værdien er et fælles beslutningsgrundlag.
Når de samme data kan bruges til at forstå både service health, risiko, brugeroplevelse og omkostninger, kan governance bevæge sig fra historisk rapportering til prioritering af konkrete forbedringer.
Et relevant ledelsesoverblik bør derfor kunne svare på spørgsmål som:
Hvilke services er vigtigst for forretningen? Hvor afviger den faktiske oplevelse fra målene? Hvilke incidents og afhængigheder påvirker servicen? Hvad koster den? Og hvor ligger det største forbedringspotentiale?
Fra events til operationel handling
Mens ServiceInsight skaber det overordnede serviceperspektiv, hjælper CGI SiteReliability360 med at forstå de operationelle signaler under det.
I komplekse IT-miljøer kan én fejl udløse alarmer fra applikationer, databaser, servere, netværk og cloudplatforme. Hvis hvert signal behandles separat, kan resultatet blive parallel fejlsøgning, unødige eskalationer og langsommere problemløsning.
SiteReliability360 samler og korrelerer signaler fra flere kilder. Ved hjælp af blandt andet AI, service mapping og historiske mønstre kan løsningen hjælpe med at identificere sandsynlige årsager, prioritere hændelser og automatisere relevante handlinger.
Eventkorrelation handler derfor om langt mere end at reducere antallet af alarmer. Det ændrer selve arbejdsgangen.
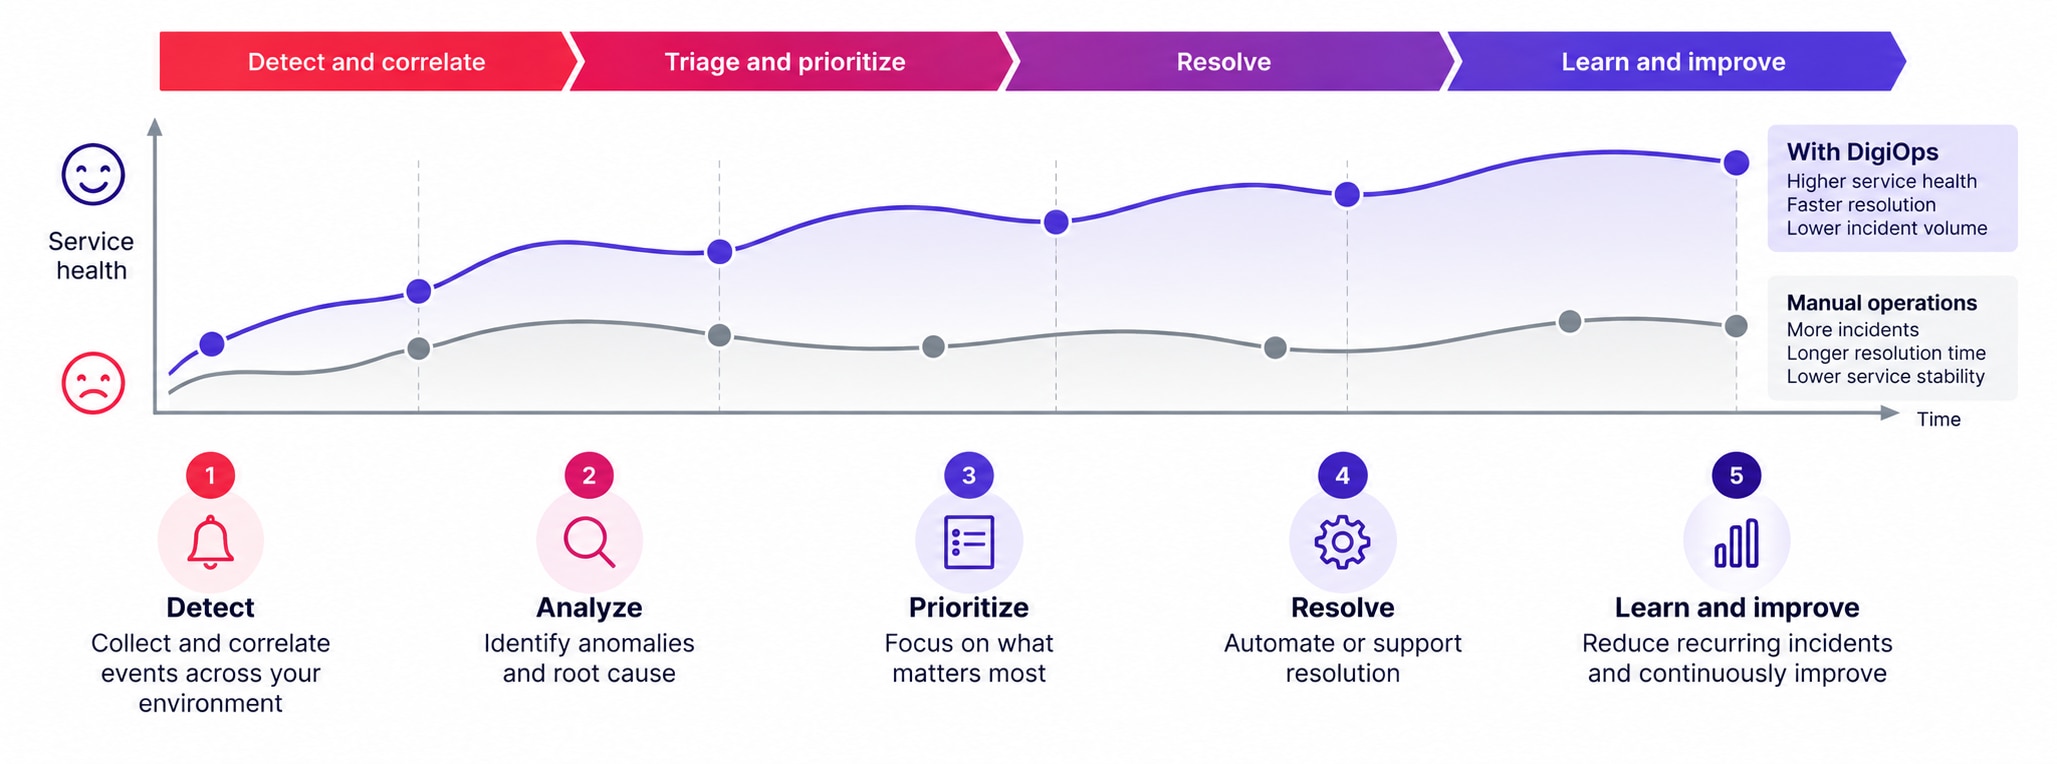
I stedet for at spørge, hvilken alarm der skal behandles først, kan driftsteamet fokusere på, hvilken forretningsservice der er påvirket, hvad den sandsynlige årsag er, og hvilken handling der vil have størst effekt.
Et konkret CGI-eksempel fra en stor energivirksomhed illustrerer potentialet. Her blev SiteReliability360 integreret med 15 eksisterende værktøjer og håndterede mere end 200.000 events om måneden. En korrelationsgrad på 92 % bidrog til 23 % autonom løsning ved første kontakt og en besparelse på mere end 1.600 arbejdstimer om måneden.
Resultaterne gælder den konkrete implementering og kan ikke overføres direkte til andre miljøer, men de illustrerer, hvordan eventkorrelation kan omsættes til reel kapacitet og højere robusthed.
Værdien er større end hurtigere incident-håndtering
Når indsigt, operationelle signaler og automatisering bindes sammen, kan effekten mærkes flere steder i organisationen.
Færre alarmer kræver manuel vurdering. Det bliver hurtigere at gå fra symptom til sandsynlig årsag. Nogle problemer kan håndteres, før de udvikler sig til forretningskritiske incidents. Ledelsen får et bedre grundlag for at prioritere efter effekt frem for volumen. Og kapacitet kan flyttes fra gentagen fejlsøgning og brandslukning til modernisering, arkitektur og forbedring af de services, der betyder mest.
Ambitionen er ikke fejlfri IT. Den er færre undgåelige incidents, tidligere indgriben og hurtigere, kontrolleret genetablering, når noget alligevel går galt.
På tværs af DigiOps-engagementer har kunder opnået 30 til 35 % mindre tid brugt på fejlsøgning, 28 til 45 % færre nedbrud og lavere MTTR samt 18 til 25 % lavere omkostninger gennem integrerede AI-services og mindre teknisk gæld. Potentialet afhænger altid af blandt andet scope, modenhed, datakvalitet, eksisterende værktøjer og graden af standardisering.
AI skal være bygget ind fra begyndelsen
Mange organisationer begynder med at lægge en copilot eller chatbot oven på eksisterende processer. Det kan skabe lokal produktivitet, men ændrer sjældent den samlede driftsmodel.
AI skaber først strukturel værdi, når den er tænkt ind i servicemodellen, datagrundlaget, workflows, governance og målepunkter fra begyndelsen.
Det betyder ikke, at alt skal automatiseres. Det betyder, at organisationen skal have taget stilling til, hvor AI må observere, anbefale, beslutte og handle.
For CIO’en rejser det fem centrale spørgsmål:
- Har vi en troværdig servicemodel?
Automation er kun så præcis som sammenhængen mellem forretningsservices, applikationer, infrastruktur, data og ejerskab. - Er vores data gode nok?
Events, CMDB-data, telemetry, tickets og ændringshistorik skal kunne forbindes og have den nødvendige kvalitet. - Hvor skal mennesket godkende?
Kendte hændelser med lav risiko kan automatiseres, mens kritiske ændringer og usikre anbefalinger bør have tydelige kontrolpunkter og ansvar. - Har vi en baseline?
Gevinster kan ikke dokumenteres uden et klart udgangspunkt for blandt andet volumes, oppetid, genetableringstid, brugeroplevelse, omkostninger og manuel indsats. - Belønner vores model den rigtige adfærd?
En leverancemodel, der belønner ticketvolumen, skaber ikke nødvendigvis incitament til at forebygge tickets. Målepunkter bør i stigende grad knyttes til service health, oplevelse, automation og forretningsresultater.
Fremtiden er styret autonomi
Det næste udviklingstrin er mere autonome driftsmodeller, hvor specialiserede AI-agenter kan overvåge signaler, analysere mønstre, koordinere workflows og gennemføre handlinger inden for tydeligt definerede rammer.
CGI DigiOps omfatter allerede et katalog med mere end 190 agenter og 400 workflows, som kan tilpasses den enkelte organisations miljø og risikoprofil.
Men fremtiden er ikke et mørklagt datacenter uden mennesker. Den er styret autonomi.
Mennesker definerer mål, guardrails, risikotolerance og ansvar. AI håndterer volumen, mønstergenkendelse og gentagelige handlinger. Specialisterne kan i højere grad bruge deres tid på komplekse problemer, arkitektur, forbedringer og dialog med forretningen.
For mange organisationer bliver modellen derfor heller ikke alt eller intet. Strategisk retning, arkitektur, data og governance kan fortsat ligge hos kunden, mens en Managed Services-partner tilfører skala, specialistkompetencer, automation og operationel disciplin dér, hvor det skaber størst værdi.
Begynd med én kritisk service
Næste generation af Managed Services behøver ikke begynde med et stort transformationsprogram.
Start med én forretningskritisk service, skab en tydelig baseline og identificér, hvor bedre data, AI og automation kan skabe en målbar forbedring.
Det kan begynde med en vurdering af den nuværende driftsmodel, datakvaliteten og værktøjslandskabet og derefter et afgrænset Proof of Value med klare succeskriterier og guardrails.
Målet er ikke at indføre mere teknologi. Målet er at skabe en driftsmodel, der ser helheden, forebygger problemer og omsætter AI til målbar forretningsværdi.
Om forfatteren

Rasmus Vittrup Halvor
Director Corporate Expert
Rasmus Vittrup Halvor er specialist inden for managed services og outsourcing. Han rådgiver direktioner og bestyrelser om de mest strategiske spørgsmål i moderne it-drift: hvordan ansvar, risiko og forretningsværdi placeres optimalt mellem kunde og leverandør i langsigtede, outcome-baserede aftaler. ...